TL;DR: Ahrefs revisó 137,210 dominios con datos de mayo de 2026. El 28 % publica un archivo llms.txt y el 97 % de esos archivos no recibió ni una sola solicitud ese mes. Google dice que su buscador lo ignora. SE Ranking no encontró relación entre tener el archivo y ser citado por una IA. Si ya lo tienes, trátalo como código y sigue. Si no lo tienes, no es tu prioridad.
Un dato del estudio de Ahrefs lo resume mejor que cualquier gráfica: Slackbot, el bot que arma las vistas previas de enlaces en Slack, pidió archivos llms.txt más veces que PerplexityBot. Es decir, la gente de marketing que se comparte el archivo en chats lo "lee" más que uno de los buscadores de IA para los que supuestamente se escribió.
Ahrefs analizó los registros de servidor de los dominios que usan su analítica y se hizo una pregunta sencilla: ¿quién pide de verdad el archivo llms.txt? Casi nadie. Lo que tienes que decidir como dueño no es si publicarlo, sino si las horas que tu equipo o tu agencia le dedica rinden más en otra parte.
¿Qué es llms.txt y para qué se propuso?
llms.txt es un archivo de texto en formato Markdown que se coloca en un sitio para resumir qué es y enlazar su contenido más importante, pensado para que modelos de lenguaje y agentes se orienten sin rastrearlo todo. Lo propuso Jeremy Howard en septiembre de 2024. No bloquea ni controla nada, a diferencia de robots.txt.
La versión 2 de la propuesta, actualizada en agosto de 2026, dice que su uso principal está en la documentación de software: un agente de programación consulta el archivo para encontrar la referencia de una API. Ahrefs agrega un punto de historia: la idea de que llms.txt mejora la "visibilidad en IA" la puso después la industria del SEO.
Dos aclaraciones para no confundirse:
- No es un robots.txt para IA. No da permisos ni prohíbe accesos.
- La propuesta también sugiere publicar versiones en Markdown de cada página, pero eso es otra pieza. El estudio de Ahrefs mide solo el archivo índice.
¿Qué encontró Ahrefs sobre llms.txt en 137,000 sitios?
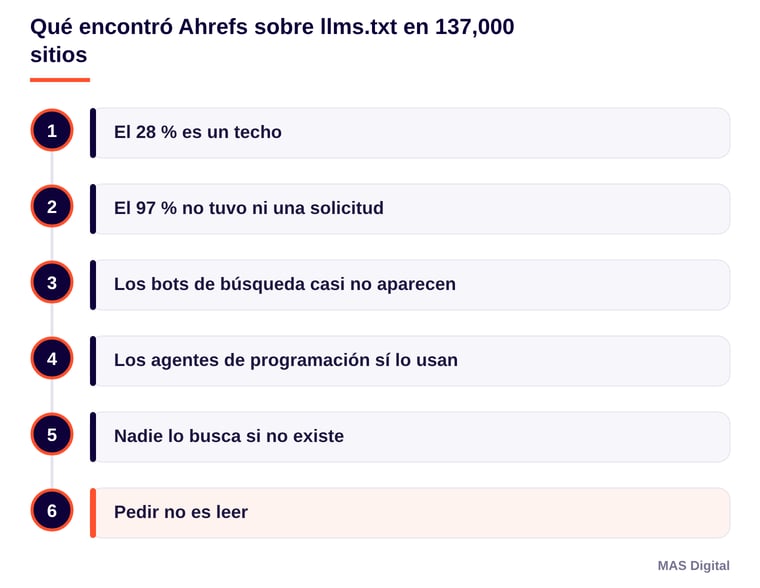
Encontró que el 28 % de los dominios publica llms.txt y que el 97 % de esos archivos no recibió ninguna solicitud en mayo de 2026. En el 3 % restante, el 96 % de las solicitudes vino de bots. Los bots de IA identificados sumaron 19.5 %, y los que buscan páginas para responder en vivo, apenas 1.1 %.
Los hallazgos que más le sirven a un dueño de negocio:
- El 28 % es un techo. Ahrefs advierte que sus clientes son más técnicos que el promedio de la web.
- El 97 % no tuvo ni una solicitud. Lo más probable al publicar el archivo es que nada lo pida.
- Los bots de búsqueda casi no aparecen. OAI-SearchBot, PerplexityBot y el buscador de Claude, juntos, hicieron unos pocos cientos de solicitudes en miles de sitios.
- Los agentes de programación sí lo usan. Claude-Code pidió el archivo más que cualquier bot de búsqueda o asistente de IA.
- Nadie lo busca si no existe. Ningún bot de IA pidió un llms.txt en sitios que no lo tenían. El 98 % de esas solicitudes fueron personas, probablemente profesionales de SEO revisando a la competencia.
- Pedir no es leer. Ahrefs aclara que una solicitud no prueba que el bot usara lo que bajó. Todas sus cifras son un techo.
Ahrefs suma un riesgo que casi nadie menciona: el bot de investigación más activo del estudio se identificaba como un sondeo de inyección de prompts. Los agentes están hechos para confiar en este archivo, y eso lo vuelve atractivo para alguien con malas intenciones.
¿Qué dicen Google y SE Ranking?
Google dice que no necesitas llms.txt para aparecer en su buscador, incluidas sus funciones de IA, porque Google Search lo ignora. SE Ranking analizó cerca de 300,000 dominios y no encontró correlación entre tener el archivo y ser citado por modelos de lenguaje. Las dos fuentes, por caminos distintos, llegan a la misma conclusión.
Google publicó su guía de optimización para IA generativa el 15 de mayo de 2026. En la sección que desmiente mitos de AEO y GEO, dice que no hace falta crear archivos de texto para IA ni marcado especial. En junio la actualizó, y Search Engine Land recogió la frase nueva: mantener un llms.txt para otros servicios está bien, y no ayuda ni perjudica en Google Search.
SE Ranking encontró que apenas el 10.13 % de su muestra tenía el archivo. Su modelo de aprendizaje automático predijo mejor las citas cuando quitaron la variable llms.txt, lo que sugiere que agregaba ruido. El 10.13 % de SE Ranking y el 28 % de Ahrefs vienen de muestras distintas y no se comparan directo.
¿Qué sí mueve tu presencia en respuestas de IA, si no es llms.txt?
La mueve lo mismo que ya funcionaba: contenido propio que vale la pena citar, páginas que los rastreadores de búsqueda pueden leer y menciones reales en otros sitios. Para Google, trabajar para sus respuestas con IA es hacer SEO. La tabla ordena las opciones por evidencia, esfuerzo y prioridad para una empresa típica.
| Acción | Qué evidencia hay | Esfuerzo | Prioridad para una empresa típica |
|---|---|---|---|
| Publicar llms.txt | Ahrefs: el 97 % no recibió solicitudes; Google lo ignora; SE Ranking: sin correlación con citas | Bajo | Baja; útil si tienes documentación técnica |
| Permitir rastreadores de búsqueda de IA | OpenAI, Anthropic y Perplexity documentan que sus bots de búsqueda muestran tu sitio | Bajo | Alta |
| Contenido propio y no genérico | Google lo pone como lo más influyente a largo plazo | Alto | Alta |
| Base técnica de SEO (indexación, velocidad, enlaces internos) | Google exige cumplir los requisitos técnicos para aparecer | Medio | Alta |
| Menciones auténticas en medios, reseñas y directorios | HubSpot dice que los motores consideran medios, reseñas y redes | Alto | Media a alta |
| Datos estructurados | Google: no son requisito para IA, pero ayudan a resultados enriquecidos | Medio | Media |
¿Cómo revisas si los bots de IA pueden entrar a tu sitio?
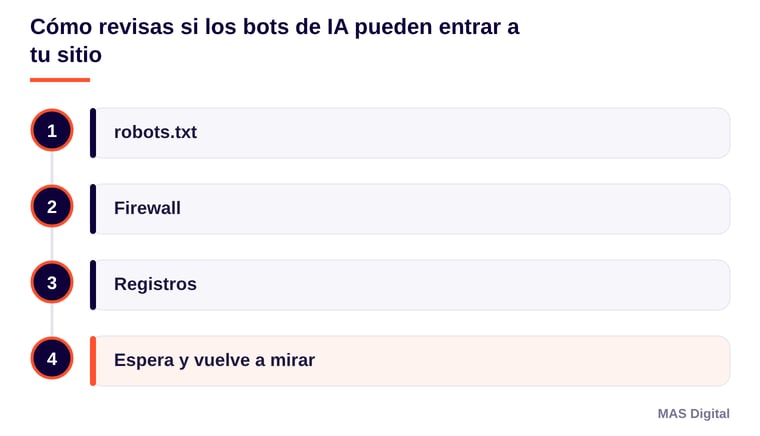
Lo revisas en tres lugares: tu robots.txt, tu firewall y tus registros de servidor. Es la acción de mayor prioridad y menor esfuerzo de la tabla. Si un bot de búsqueda de IA no puede entrar, ningún archivo ni contenido te va a poner en sus respuestas. La revisión toma una tarde.
- robots.txt. Confirma que no bloquee a OAI-SearchBot (búsqueda de ChatGPT), Claude-SearchBot y Claude-User (Claude) ni PerplexityBot. Los bots de entrenamiento, como GPTBot o ClaudeBot, se controlan aparte: bloquearlos no te saca de la búsqueda.
- Firewall. Si usas Cloudflare u otro firewall de aplicaciones web, revisa sus reglas de bots. Perplexity documenta que puede hacer falta permitir sus bots de forma explícita, y OpenAI publica rangos de IP para el suyo.
- Registros. Pide a tu proveedor de hosting que filtre las visitas por nombre de bot. Si no aparece ninguno de búsqueda de IA en un mes, algo los está frenando.
- Espera y vuelve a mirar. OpenAI y Perplexity dicen que un cambio en robots.txt puede tardar hasta unas 24 horas en reflejarse.
En MAS empezamos por lo básico: robots.txt y los registros del servidor, antes que llms.txt. Confirma qué bots entran, a qué páginas llegan y si alguna regla los bloquea sin querer. Los archivos nuevos se discuten después.
¿Deberías borrar tu llms.txt si ya lo tienes?
No hace falta borrarlo. Si tu plataforma lo genera sola, déjalo, pero trátalo como código: revisa qué dice, limita quién lo edita y vigila los cambios. Lo que sí conviene es dejar de invertir horas en afinarlo. Con un 97 % de archivos sin una sola solicitud, el retorno esperado es casi cero.
Esto pasa más de lo que crees. Según llmstxt.org, Wix lo genera para cada sitio y plugins de WordPress como Yoast SEO o AIOSEO también pueden hacerlo. Muchas empresas tienen el archivo sin haberlo decidido.
Ahrefs propone cuatro pasos si de todos modos quieres mantenerlo:
- Revisa tus registros antes de invertir más. Si nadie lo pide, ya tienes tu respuesta.
- Deja que tu plataforma lo genere. Así el esfuerzo queda en cero.
- Enlázalo si de verdad quieres que lo lean. Los agentes lo piden cuando algo les indica que existe, no por iniciativa propia.
- Protégelo como código. Control de versiones, pocos editores, alerta de cambios, solo enlaces y descripciones, nada que parezca una instrucción.
¿Quién sí debería mantener un llms.txt?
Deberían mantenerlo las empresas con documentación técnica que usan desarrolladores: APIs, librerías, plataformas de software con guías de integración. Ahí es donde los agentes de programación lo piden. Para una tienda, un despacho de servicios o una marca de consumo, el archivo casi no tiene lectores por ahora.
Si eres una software factory o un SaaS con documentación pública, vale la pena tenerlo bien hecho y enlazado desde tus docs. Si eres una empresa de servicios en Guatemala, tus horas rinden más en lo que explica nuestro artículo sobre mitos de SEO que conviene dejar atrás: menos atajos, más contenido que responde.
¿En qué conviene invertir las horas de AEO del próximo trimestre?
Conviene invertirlas en tres frentes: acceso de los rastreadores de búsqueda, SEO técnico y contenido que alguien quiera citar. Ahí apunta la evidencia de Ahrefs, Google y SE Ranking. Como dueño, tu decisión es el orden y el presupuesto. Si alguien te vende llms.txt como estrategia de visibilidad en IA, pide sus datos.
Un orden simple para el trimestre:
- Semana 1: revisión de robots.txt, firewall y registros.
- Mes 1: arreglos técnicos de indexación y velocidad en tus páginas que más venden.
- Meses 2 y 3: contenido propio para las preguntas que hace tu comprador y menciones legítimas en medios y directorios del sector.
Ese diagnóstico es el primer paso de nuestra optimización AEO y GEO.
Todo eso se apoya en el mismo trabajo de base de nuestro servicio de SEO.
No le dediques horas a llms.txt. Dedícaselas a contenido que alguien quiera citar y a que los rastreadores de búsqueda puedan entrar a tu sitio.
¿Qué preguntan las empresas sobre llms.txt?
Preguntan si tenerlo los perjudica, si ChatGPT lo lee, si deben pagar para que alguien lo haga y si es inútil. Google dice que no ayuda ni perjudica en su buscador. Ahrefs vio muy pocas solicitudes de bots de búsqueda de IA. Y pagar horas por crearlo rara vez se justifica fuera de la documentación técnica.
¿Tener llms.txt me perjudica en Google?
No. Google dice que su buscador lo ignora: no ayuda ni perjudica.
¿ChatGPT o Perplexity leen mi llms.txt?
Ahrefs vio muy pocas solicitudes de sus bots de búsqueda. Para aparecer en esas respuestas importa más que OAI-SearchBot y PerplexityBot puedan entrar a tu sitio.
¿Vale la pena pagar para que lo hagan?
Rara vez. Si tu plataforma lo genera sola, basta con revisarlo. Si alguien te cobra horas por afinarlo, pregunta qué datos respaldan ese trabajo.
¿Entonces llms.txt es inútil?
No para todos. Es útil para documentación técnica que consultan agentes de programación.
¿Revisamos dónde inviertes tus horas de AEO? Si quieres saber qué mueve de verdad tu presencia en respuestas de IA, habla con MAS Digital. Empezamos por lo que dicen los datos de tu sitio, no por archivos de moda.
¿Qué estudios y documentos citamos sobre llms.txt?
Citamos el estudio de Ahrefs con datos de mayo de 2026, el análisis de SE Ranking, la guía de Google sobre IA generativa y su anuncio del 15 de mayo, la nota de Search Engine Land, la propuesta en llmstxt.org y la documentación de HubSpot y de los rastreadores de IA. Todo se revisó el 15 de octubre de 2026.
- Ahrefs, "We Analyzed 137K Sites: 97% of llms.txt Files Never Get Read" (datos de mayo de 2026)
- SE Ranking, "Does LLMs.txt impact your AI visibility and citations?"
- Google Search Central, "Optimizing your website for generative AI features on Google Search"
- Google Search Central Blog, "A new resource for optimizing for generative AI in Google Search" (15 de mayo de 2026)
- Search Engine Land, "Google says llms.txt files won't harm or help your search rankings" (15 de junio de 2026)
- llmstxt.org, "The /llms.txt file, v2"
- HubSpot, "Introducing HubSpot AEO" (14 de abril de 2026)
- Documentación de rastreadores de OpenAI, Anthropic y Perplexity: https://developers.openai.com/api/docs/bots · https://support.claude.com/en/articles/8896518-does-anthropic-crawl-data-from-the-web-and-how-can-site-owners-block-the-crawler · https://docs.perplexity.ai/docs/resources/perplexity-crawlers
Cómo revisamos este contenido: el equipo de MAS Digital volvió a abrir cada fuente el 19 de octubre de 2026 y comprobó que respalda lo que citamos. Si una fuente cambia, actualizamos el texto y la fecha.

Descubre por qué
somos la agencia que necesitas.
